🤖💻 El futuro del setup de TI: de tener un computador potente a tener nuestra propia IA
-
Inicio
-
🤖💻 El futuro del setup de TI: de tener un computador potente a tener nuestra propia IA
🤖💻 El futuro del setup de TI: de tener un computador potente a tener nuestra propia IA
Septiembre de 2026. Durante años, cuando alguien del área de tecnología quería mejorar su computador pensaba principalmente en más procesador, RAM, almacenamiento y quizá una mejor tarjeta gráfica. Hoy ese criterio está cambiando.

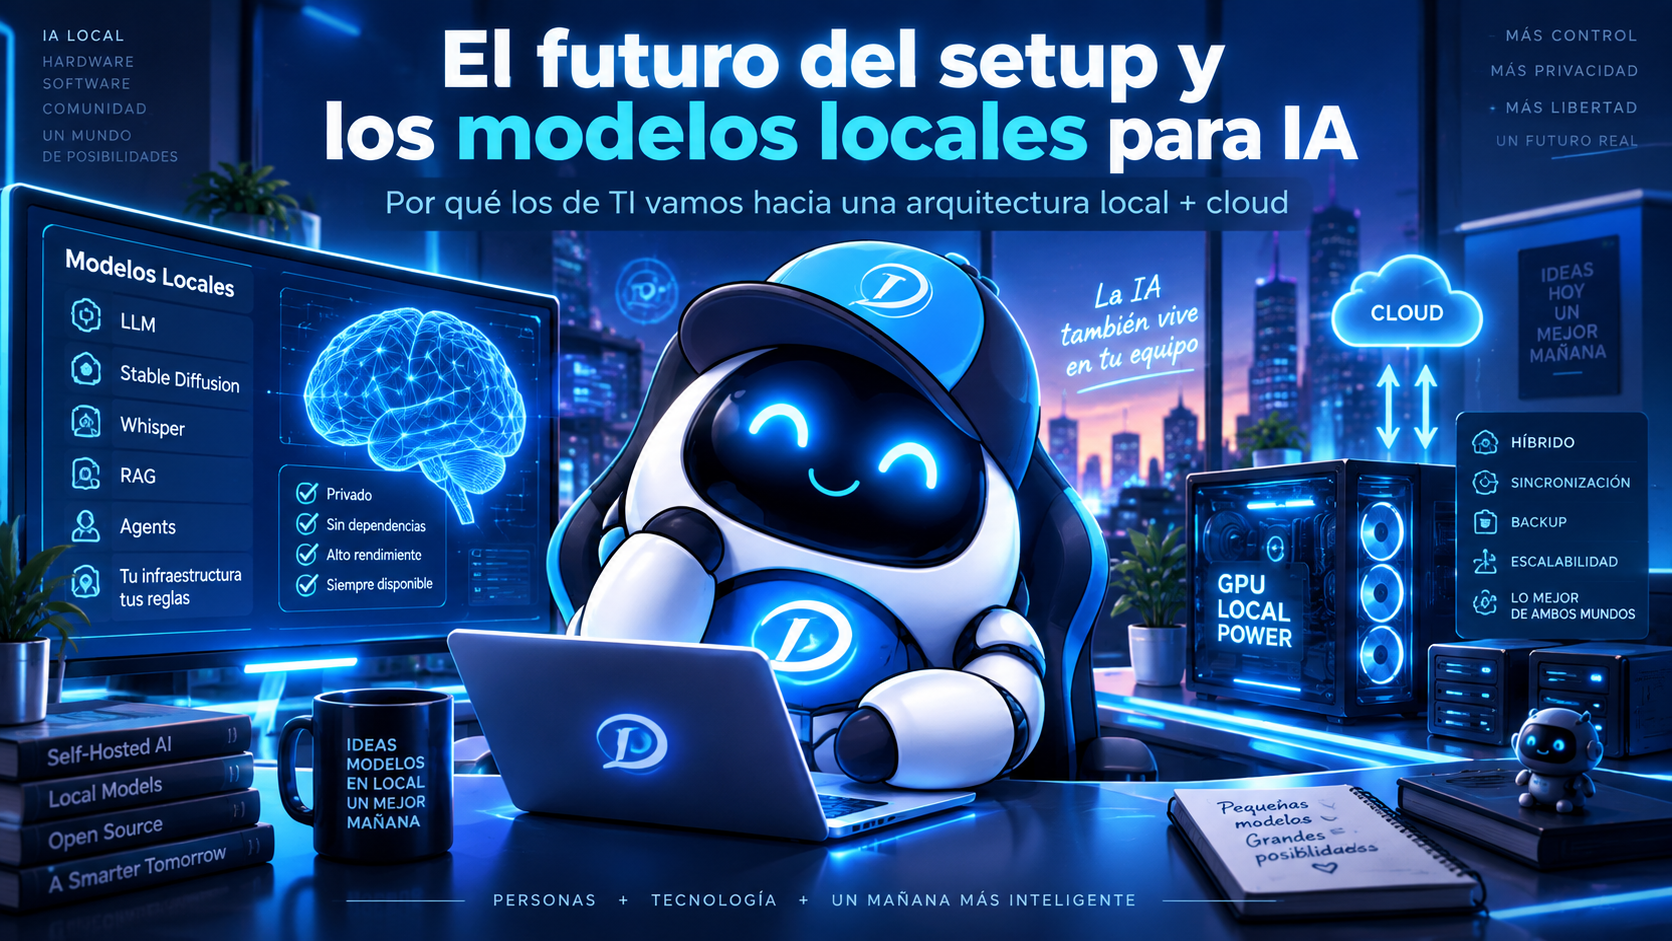
La siguiente generación de setups empieza a diseñarse alrededor de otra pregunta:
¿Qué modelos de inteligencia artificial puedo ejecutar directamente en mi propia máquina?
Y ya no estamos hablando solamente de pequeños experimentos.
OpenAI dispone actualmente de gpt-oss-20b y gpt-oss-120b, modelos de pesos abiertos diseñados específicamente para ejecutarse en infraestructura controlada por el usuario. El modelo de 20B puede funcionar en dispositivos con alrededor de 16 GB de memoria, mientras que el modelo de 120B está pensado para hardware con aproximadamente 80 GB de memoria de GPU. Además, son compatibles con ecosistemas como Ollama, llama.cpp y vLLM. OpenAI
Esto representa un cambio importante: modelos con capacidades avanzadas de razonamiento ya pueden vivir dentro de la infraestructura de una empresa o incluso dentro del computador de un desarrollador.
🧠 El hardware también está cambiando
Los fabricantes ya están diseñando computadores pensando en IA local.
Microsoft establece 40 TOPS de NPU o más para muchas de las funciones de sus Copilot+ PC. Qualcomm ya dispone de procesadores Snapdragon X con 45 TOPS y generaciones que alcanzan hasta 80 TOPS. Microsoft Learn
AMD, por su parte, tiene plataformas Ryzen AI Max+ 395 con 128 GB de memoria LPDDR5X, CPU Zen 5 de 16 núcleos, GPU Radeon 8060S y NPU XDNA 2. Es prácticamente un pequeño servidor de IA contenido en un equipo compacto. AMD
Y NVIDIA llevó el concepto todavía más lejos con DGX Spark: 128 GB de memoria unificada, arquitectura Grace Blackwell y hasta 1 PFLOP FP4, diseñado para desarrollar y probar modelos de hasta 200.000 millones de parámetros desde el escritorio. NVIDIA
Lo que antes requería infraestructura especializada de centro de datos empieza a aparecer, a otra escala, encima del escritorio del desarrollador.
🚀 ¿Por qué los que trabajamos en TI vamos hacia allí?
Hay varias razones técnicas y económicas.
🔒 Privacidad. Bases de datos, código fuente, documentación interna, información de clientes o procesos empresariales pueden analizarse sin enviarse permanentemente hacia servidores externos.
⚡ Latencia. Para muchas tareas, eliminar el viaje PC → Internet → API → Internet → PC produce una experiencia mucho más inmediata.
💰 Costos. Una API seguirá siendo extremadamente conveniente para tareas puntuales y para acceder a los modelos más potentes. Pero si una empresa ejecuta miles o millones de inferencias repetitivas, disponer de capacidad propia puede transformar parte de ese gasto variable por tokens en infraestructura propia.
🌐 Independencia de Internet. Un modelo local continúa funcionando aunque la conexión falle o un proveedor tenga una interrupción.
🛠️ Control. Podemos escoger el modelo, cuantización, contexto, RAG, herramientas, bases de conocimiento y agentes que necesitamos.
🤖 Agentes funcionando permanentemente. Aquí probablemente está uno de los cambios más grandes. Ya no queremos únicamente un chatbot al que hacerle preguntas: queremos procesos autónomos ejecutándose durante horas.
Y esto último ya está ocurriendo.
OpenClaw permite conectar agentes de IA con WhatsApp, Telegram, Slack, Discord y otras plataformas manteniendo el gateway y los modelos en infraestructura propia. Ollama también está impulsando OpenJarvis, un proyecto orientado explícitamente hacia una filosofía local-first, donde la nube se utiliza solamente cuando resulta necesaria. Ollama
☁️ Pero la nube no va a desaparecer
Probablemente aquí está la interpretación más importante.
El futuro no parece ser “local contra nube”.
Parece ser:
LOCAL + CLOUD
La IA local atenderá privacidad, automatizaciones permanentes, búsquedas sobre documentos internos, clasificación, tareas repetitivas, código y operaciones de baja latencia.
La nube seguirá entrando cuando necesitemos modelos enormes, razonamiento de frontera, búsquedas externas, generación multimedia muy pesada o grandes picos de capacidad.
IDC incluso describe esta transición como una migración hacia arquitecturas dispositivo–edge–cloud. Su previsión para 2026 apunta a alrededor de 50 millones de GenAI PC, cerca del 19,6 % del mercado mundial de PCs previsto por la firma. IDC
Y otro análisis reciente de IDC lo resume todavía mejor: NVIDIA y Microsoft están apostando a que una parte significativa de la IA futura se ejecute directamente donde está el usuario, mediante modelos y agentes locales. IDC
🔥 Y aquí es donde un “setup” deja de ser simplemente un setup
En nuestro caso, experimentar con Ubuntu + Ollama + modelos locales + OpenClaw puede parecer hoy solamente un laboratorio.
Pero conceptualmente estamos construyendo algo diferente:
una infraestructura personal de IA.
Hoy puede ser un modelo pequeño ejecutándose en un PC convencional.
Mañana puede ser:
🧠 64 o 128 GB de memoria
🎮 GPU/NPU especializada para inferencia
💾 varios terabytes de modelos y conocimiento empresarial
🤖 agentes ejecutándose 24/7
📱 acceso desde WhatsApp o cualquier dispositivo
🏢 modelos especializados en los procesos de nuestra empresa
☁️ conexión con modelos cloud solamente cuando sea necesario
Para quienes trabajamos en sistemas, desarrollo, infraestructura y automatización, probablemente el computador del futuro no se medirá únicamente por sus GHz.
Lo empezaremos a medir por VRAM, ancho de banda de memoria, TOPS, tokens por segundo y qué tan grande es el modelo que podemos ejecutar sin depender de terceros.
🧑💻 El nuevo setup del profesional de TI no será solamente su computador.
Será su propio pequeño centro de datos de inteligencia artificial.
Compartir esta publicación:
Conversemos (0)
Comparte tu opinión y participa en la conversación.
Sé la primera persona en comentar.


